> For the complete documentation index, see [llms.txt](https://docs.geopard.tech/geopard-tutorials/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://docs.geopard.tech/geopard-tutorials/in/agronomy/comparing-yield-datasets.md).

# उपज डेटा सेट की तुलना

मौसमी फसल प्रदर्शन की गहरी समझ पाने के लिए उपज डेटा सेट की तुलना करें, जिसमें उचित Yield Cleaning और Calibration तथा Synthetic Yield का उपयोग शामिल है।

## संदर्भ

आधुनिक कृषि निर्णय-निर्धारण काफी हद तक यील्ड डेटासेट्स पर निर्भर करता है, जो संकलित उपज का प्रतिनिधित्व करते हैं और कृषक की आय का एक बड़ा हिस्सा दर्शाते हैं। इन डेटासेट्स को इनपुट प्रबंधन पर निर्णय लेने और भविष्य की बुवाई तथा उर्वरण रणनीतियों को अनुकूलित करने के लिए सटीक और उच्च गुणवत्ता का होना चाहिए।

यील्ड डेटा सामान्यतः हार्वेस्टिंग उपकरणों द्वारा एकत्र किया जाता है, लेकिन कच्चे रीडिंग अक्सर अपूर्ण होती हैं, त्रुटियां होती हैं, या सेंसर असंगतियों और खेत की बदलती परिस्थितियों को संभालने के लिए कैलिब्रेशन की आवश्यकता होती है। इन चुनौतियों को पार करने के लिए प्रोफेशनल आमतौर पर क्लीनिंग, कैलिब्रेशन और सिम्युलेटेड/सिंथेटिक डेटासेट जनरेशन तकनीकें लागू करते हैं ताकि विश्वसनीय, तुलनीय यील्ड डेटा उत्पन्न हो सके।

दोनों[ यील्ड क्लीनिंग और कैलिब्रेशन](/geopard-tutorials/in/agronomy/yield-calibration-and-cleaning.md) और [यील्ड डेटा का सिंथेटिक बहालीकरण](/geopard-tutorials/in/agronomy/synthetic-yield-map.md) GeoPard द्वारा समर्थित हैं।

<mark style="color:डिफ़ॉल्ट;background-color:yellow;">विभिन्न फसल वर्षों के यील्ड डेटासेट्स की तुलना महत्वपूर्ण जानकारी देती है, जिससे प्रबंधन प्रथाओं की पुष्टि होती है, सेंसर की सटीकता का सत्यापन होता है, और आगामी मौसमों के लिए रणनीतियाँ सुधारने में मदद मिलती है।</mark> ये तुलनाएँ उर्वरक और बीजारोपण नुस्खों के परिष्कार का भी मार्गदर्शन करती हैं, यह सुनिश्चित करते हुए कि प्रत्येक निर्णय भरोसेमंद जानकारी पर आधारित हो।

## तुलना का दृष्टिकोण (समानता समीकरण का उपयोग)

यील्ड डेटासेट्स की मात्रात्मक तुलना करने के लिए, हम एक पूर्व-संरक्षित समीकरण का उपयोग करते हैं जिसका नाम है <mark style="color:डिफ़ॉल्ट;background-color:yellow;">स्थानिक सहसंबंध विश्लेषण (डेटा लेयर्स समानता)</mark> जो स्थानिक आधार पर यील्ड से जुड़ी विशेषताओं के बीच समानता को मापता है।

यह समीकरण समानता स्कोर असाइन करता है, जो बताता है कि एक डेटासेट spatial पैटर्न और मान वितरण में दूसरे से कितनी मिलती-जुलती है।&#x20;

<figure><img src="https://537187778-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FYICBELdyAXXebKAzfLOR%2Fuploads%2F9O2baZdOVQWoiJrJqPdv%2Fimage.png?alt=media&amp;token=4014a70b-804e-46fa-8206-19f58cc345cd" alt=""><figcaption><p>मौजूदा डेटा लेयर्स समानता समीकरण खोजें</p></figcaption></figure>

<mark style="color:डिफ़ॉल्ट;background-color:yellow;">समानता मान 0 से 1 के बीच होते हैं, जहाँ 0 का अर्थ है कोई मेल नहीं और 1 का अर्थ है 100% मान-स्थानिक मेल</mark>। दूसरे शब्दों में, जितना समानता स्कोर 1 के करीब होगा, उतनी ही अधिक यील्ड विशेषताएँ समान होंगी।&#x20;

## **वास्तविक यील्ड डेटासेट (2015** सोयाबीन **बनाम 2018** सोयाबी&#x928;**)**

इस उदाहरण में, हम दो अलग-अलग विकास मौसमों 2015 और 2018 के दौरान एकत्रित कच्चे यील्ड डेटा के साथ शुरू करते हैं, जिनमें समान फसल सोयाबीन है। प्रारंभिक डेटासेट्स में असामान्य रूप से उच्च और निम्न स्थान होते हैं, खासकर हार्वेस्टर पास के शुरू/अंत में, और डेटा को थोड़े से पुनर्रचना/कैलिब्रेशन की आवश्यकता होती है।

GeoPard के क्लीनिंग और कैलिब्रेशन टूल्स लागू करने के बाद, प्राप्त डेटासेट अधिक समान, सुसंगत और समझने में आसान हो गया है।

<figure><img src="https://537187778-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FYICBELdyAXXebKAzfLOR%2Fuploads%2FDTbHLvB354jBMO3fub2W%2Fimage.png?alt=media&amp;token=6ca5f428-021b-453d-b6c7-330038294e0c" alt=""><figcaption><p>सोयाबीन 2015: मूल बनाम साफ़ और कैलिब्रेटेड यील्ड डेटा</p></figcaption></figure>

<figure><img src="https://537187778-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FYICBELdyAXXebKAzfLOR%2Fuploads%2FaiDl2niPiQyUwQ6kDTdW%2Fimage.png?alt=media&amp;token=7bb1ccdb-b41c-4590-b47f-a803cdbe8e01" alt=""><figcaption><p>सोयाबीन 2018: मूल बनाम साफ़ और कैलिब्रेटेड यील्ड डेटा</p></figcaption></figure>

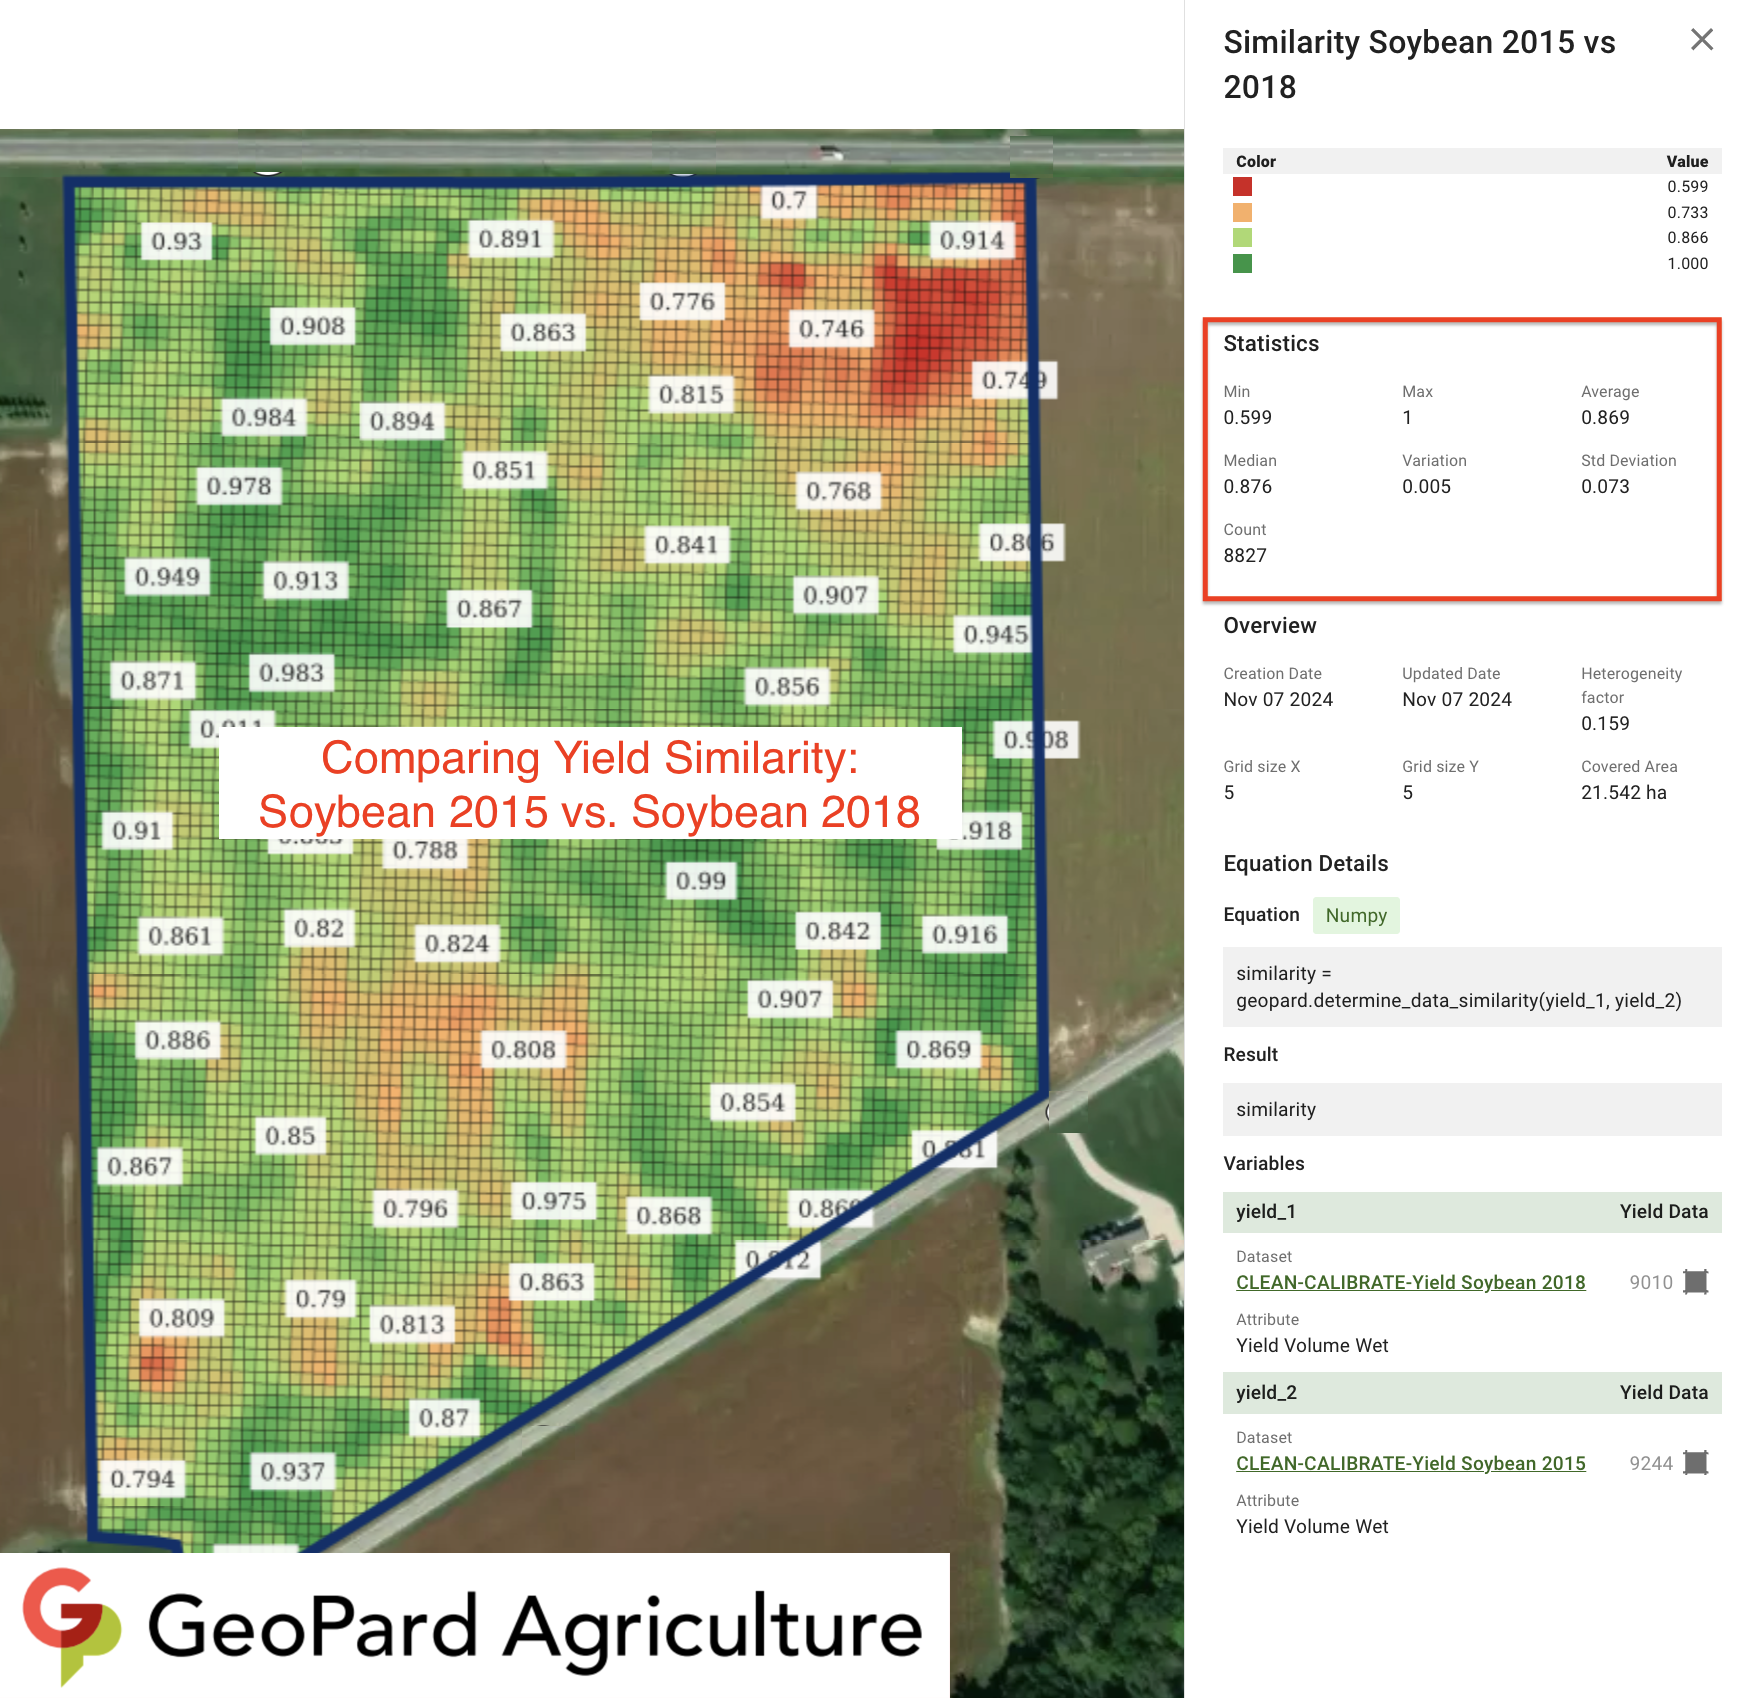
समानता समीकरण निष्पादन का मानचित्र नीचे स्क्रीनशॉट के रूप में है।

सांख्यिकीय दृष्टिकोण से, यह उच्च औसत (0.869) और माध्य (0.876) दिखाता है, जो संकेत करता है कि <mark style="color:डिफ़ॉल्ट;background-color:yellow;">2018 की सोयाबीन यील्ड पैटर्न 2015 से काफी मिलते-जुलते हैं</mark>। जबकि कुछ क्षेत्रों में यह 0.599 तक घट जाता है, कम परिवर्तन (0.005) और मामूली मानक विचलन (0.073) यह पुष्ट करते हैं कि <mark style="color:डिफ़ॉल्ट;background-color:yellow;">कुल मिलाकर सुसंगतता</mark>.&#x20;

कृषि विज्ञान के दृष्टिकोण से, <mark style="color:डिफ़ॉल्ट;background-color:yellow;">यह स्थिरता सुझाती है कि खेत की अंतर्निहित परिस्थितियाँ और प्रबंधन प्रथाओं पर प्रतिक्रिया ज्यादातर अपरिवर्तित रही हैं</mark>.

<figure><img src="https://537187778-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FYICBELdyAXXebKAzfLOR%2Fuploads%2FAyZjM18FRfT03KXUX2yW%2Fimage.png?alt=media&amp;token=d48c86e2-0aa0-4eb4-b626-29e645399a77" alt=""><figcaption><p>यील्ड समानता की तुलना: सोयाबीन 2015 बनाम सोयाबीन 2018</p></figcaption></figure>

## **वास्तविक यील्ड डेटासेट (2022** मक्का **बनाम 2024** मक्क&#x93E;**)**

इस परिदृश्य में, हम दो मक्का मौसमों — 2022 और 2024 — के कच्चे यील्ड डेटा के साथ शुरू करते हैं। प्रारंभिक डेटासेट्स में असामान्य रूप से उच्च या निम्न रीडिंग, क्रॉस पास और वक्र रास्ते जैसे अनोमलीज़ शामिल हैं, जो सेंसर पुनःकैलिब्रेशन की आवश्यकता का संकेत देती हैं।&#x20;

GeoPard के क्लीनिंग और कैलिब्रेशन टूल्स लागू करने के बाद, डेटासेट्स अधिक विश्वसनीय बन जाते हैं, जिससे स्वचालित विश्लेषण और सूचित निर्णय-निर्धारण संभव होता है।

<figure><img src="https://537187778-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FYICBELdyAXXebKAzfLOR%2Fuploads%2FrCMUu65DPZjqVmuvoUvM%2Fimage.png?alt=media&amp;token=00c11d5e-70b7-49ea-9943-0e4ac5b2b990" alt=""><figcaption><p>मक्का 2022: मूल बनाम साफ़ और कैलिब्रेटेड यील्ड डेटा</p></figcaption></figure>

<figure><img src="https://537187778-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FYICBELdyAXXebKAzfLOR%2Fuploads%2Ff53cGgbe2gWO4LbW2OUN%2Fimage.png?alt=media&amp;token=f48408bd-662e-44f8-9fca-c334b23324b8" alt=""><figcaption><p>मक्का 2024: मूल बनाम साफ़ और कैलिब्रेटेड यील्ड डेटा</p></figcaption></figure>

समानता समीकरण निष्पादन का मानचित्र नीचे स्क्रीनशॉट के रूप में है।

सांख्यिकीय दृष्टिकोण से, औसत 0.791 और माध्य 0.799 यह दर्शाते हैं कि <mark style="color:डिफ़ॉल्ट;background-color:yellow;">2024 के मक्का की उपज बड़े पैमाने पर 2022 से मिलती-जुलती है</mark>, हालांकि 0.413 तक के क्षेत्रों में विविधता का संकेत मिलता है। 0.115 का मानक विचलन यह पुष्टि करता है कि <mark style="color:डिफ़ॉल्ट;background-color:yellow;">खेत के विभिन्न हिस्सों में कुछ अंतर हैं</mark>.

कृषि विज्ञान के दृष्टिकोण से, <mark style="color:डिफ़ॉल्ट;background-color:yellow;">सुसंगत पैटर्न समय के साथ स्थिर परिस्थितियों और प्रभावी प्रबंधन का संकेत देते हैं</mark>। हालांकि, स्थानीयकृत <mark style="color:डिफ़ॉल्ट;background-color:yellow;">कम-समानता वाले जोन भविष्य की उपज प्रदर्शन में सुधार के लिए लक्षित समायोजन की मांग कर सकते हैं</mark>.

<figure><img src="https://537187778-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FYICBELdyAXXebKAzfLOR%2Fuploads%2FhOWLFRX43inp21kga5y9%2Fimage.png?alt=media&amp;token=308de900-e22a-4330-b517-a88ca89c5012" alt=""><figcaption><p>यील्ड समानता की तुलना: मक्का 2022 बनाम मक्का 2024</p></figcaption></figure>

## **सिंथेटिक बनाम वास्तविक यील्ड डेटासेट (2023** तिलहन/ऑयलसीड रेप)

इस परिदृश्य में, हम 2023 के तिलहन मौसम से कच्चा यील्ड डेटासेट और उसी फसल तथा वर्ष 2023 के लिए सिंथेटिक रूप से जनरेटेड यील्ड डेटासेट के साथ शुरू करते हैं। <mark style="color:डिफ़ॉल्ट;background-color:yellow;">उद्देश्य वास्तविक बनाम सिंथेटिक यील्ड की स्थानिक सटीकता का मूल्यांकन करना है, ताकि बिना-लॉग किए गए डेटा को भरने, यील्ड डेटा में अंतरालों को दूर करने, और असामान्यताओं को सिंथेटिक मानों से ठीक करने का मार्ग मिल सके।</mark>। वास्तविक यील्ड डेटासेट में असामान्य रूप से उच्च या निम्न रीडिंग, क्रॉस पास, वक्र रास्ते, और शून्य पास जैसी समस्याएँ होती हैं, जो सभी सेंसर पुनःकैलिब्रेशन की आवश्यकता को दर्शाती हैं।

GeoPard के [क्लीनिंग और कैलिब्रेशन](/geopard-tutorials/in/agronomy/yield-calibration-and-cleaning.md) को वास्तविक यील्ड डेटा पर लागू करने और [सिंथेटिक यील्ड](/geopard-tutorials/in/agronomy/synthetic-yield-map.md) तिलहन के लिए जनरेट करने के बाद, हम उनकी समानता की अर्थपूर्ण तुलना शुरू कर सकते हैं।

<figure><img src="https://537187778-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FYICBELdyAXXebKAzfLOR%2Fuploads%2FwkCRiie2suhom6bxWKCJ%2Fimage.png?alt=media&amp;token=f4752a43-55e2-431c-a667-8363c8f742c6" alt=""><figcaption><p>तिलहन 2023: मूल बनाम साफ़ और कैलिब्रेटेड यील्ड डेटा</p></figcaption></figure>

<figure><img src="https://537187778-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FYICBELdyAXXebKAzfLOR%2Fuploads%2Fz427malsrdHAQOCNjQyh%2Fimage.png?alt=media&amp;token=26a63983-2a7f-48b2-bfc9-3e40a883582a" alt=""><figcaption><p>तिलहन सिंथेटिक यील्ड 2023</p></figcaption></figure>

समानता समीकरण निष्पादन का मानचित्र नीचे स्क्रीनशॉट के रूप में है।

सांख्यिकीय दृष्टिकोण से, उच्च औसत (0.889) और माध्य (0.904) स्कोर यह संकेत देते हैं कि, <mark style="color:डिफ़ॉल्ट;background-color:yellow;">कुल मिलाकर, सिंथेटिक यील्ड डेटासेट वास्तविक 2023 तिलहन उपज के स्थानिक पैटर्न से काफ़ी मेल खाता है</mark>। जबकि एक क्षेत्र 0.291 तक गिरता है, कम परिवर्तन (0.006) और मामूली मानक विचलन (0.08) यह सुझाव देते हैं कि <mark style="color:डिफ़ॉल्ट;background-color:yellow;">क्षेत्र के अधिकांश हिस्से वास्तविक और सिंथेटिक डेटासेट्स के बीच निकटता से संरेखित हैं, और बहुत कम अपवाद हैं</mark>.

कृषि विज्ञान के दृष्टिकोण से, यह मजबूत समानता संकेत देती है कि <mark style="color:डिफ़ॉल्ट;background-color:yellow;">सिंथेटिक यील्ड डेटा वास्तविक क्षेत्रीय परिस्थितियों के लिए एक विश्वसनीय स्थानापन्न के रूप में कार्य कर सकता है</mark>, जिससे मॉडल किए गए परिदृश्यों का उपयोग निर्णय-निर्देश के रूप में करने में भरोसा बढ़ता है। <mark style="color:डिफ़ॉल्ट;background-color:yellow;">वास्तविक यील्ड डेटा में परिलक्षित कृषि प्रथाएँ सिंथेटिक यील्ड मॉडल द्वारा अच्छी तरह से कैप्चर की जाती हैं</mark>, जो भविष्य की प्रबंधन रणनीतियों के लिए अधिक सूचित और सुसंगत योजना सक्षम बनाती हैं।

<figure><img src="https://537187778-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FYICBELdyAXXebKAzfLOR%2Fuploads%2FZT4vMwtGPgMFsmWAsIb4%2Fimage.png?alt=media&amp;token=bf195514-380e-43fb-bbee-5922dd92b769" alt=""><figcaption><p>यील्ड समानता की तुलना तिलहन: वास्तविक 2023 बनाम सिंथेटिक 2023</p></figcaption></figure>


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.

Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:

```
GET https://docs.geopard.tech/geopard-tutorials/in/agronomy/comparing-yield-datasets.md?ask=<question>&goal=<user_goal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.